引子:一个被用滥了的词
打开任何一篇讲大模型的文章,你大概率会撞见一句话:”模型涌现出了某种能力。”(The model exhibits emergent abilities.)这个词现在用得太顺口,顺口到没人停下来问一句,它到底指什么。
我自己也犯过这个毛病。做物理那些年,”涌现”在我嘴里是个有分量的词,背后站着相变、序参量、临界指数这一整套能写成方程、能拿实验逼问的硬东西。后来转去做AI,发现同一个词被拿来形容大模型,意思却滑得厉害,有时指”参数堆够了某个能力突然冒出来”,有时指”训练很久之后模型忽然开窍”,有时干脆就是”我们也不知道它怎么做到的”的体面说法。
所以这篇文章想回答一个具体的问题:大模型的”涌现”,到底是模型真长出了新本事,还是我们的测量方式制造出来的错觉。
这个问题不是文字游戏。它背后有一场到现在还没吵完的学术争论,一方说最出名的那些”涌现能力”是统计幻觉,另一方说不对,有些涌现挺过了最严格的检验。更有意思的是,这场争论里第一个被拉出来盘问的,恰恰是”涌现”这个概念自己最拿得出手的案例。
我们先来看这个词从哪来,它在物理和复杂系统里本来是什么严格意思。再看它搬进AI之后长出了几副面孔。最后看那场争论,以及它给这个两百年的老概念带来了什么真正新的东西。
一、“涌现”这个词的来历
涌现不是AI发明的词,它有将近两百年的家底。这一章只做铺垫,相变、自组织、圣塔菲那套硬核机制我在《什么是耗散结构理论》那篇里已经展开过,这里只给一条够用的主线,不重复。
 什么是耗散结构理论?它和AI有关系吗?7 赞同 · 0 评论 文章
1.1 哲学的种子:从密尔到”emergent”这个词
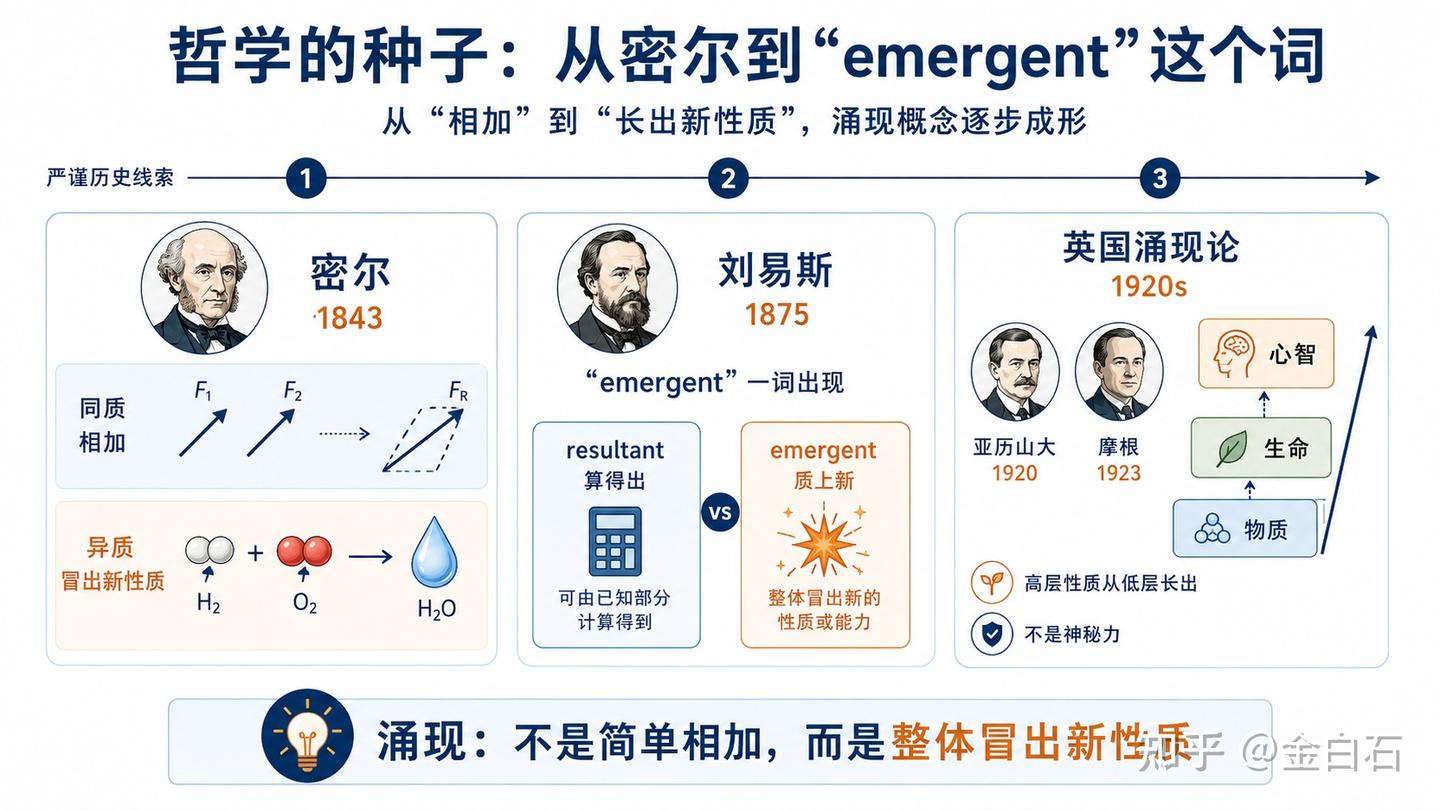
这条线常被上溯到英国哲学家约翰·斯图尔特·密尔(John Stuart Mill)。他在1843年的《逻辑体系》里给了一个后来被反复引用的起点。他把因果分成两类:一类叫”同质的”,多个原因的合效果就是各自效果相加,比如两个力按平行四边形法则合成。另一类他叫”异质的”,合在一起会冒出单看各部分时根本没有的性质,他举的例子是化学,氢和氧的性质里看不出水的性质。
不过,涌现”emergent”这个词正式出现要晚得多,是后来的乔治·亨利·刘易斯(George Henry Lewes)在1875年的《生命与心智问题》里造出来的。刘易斯把效果分成两种,一种叫resultant,能靠加加减减算出来。另一种叫emergent,质上是全新的,算不出来。这个”算不算得出来”的区分,是整个涌现概念的起点,后面会一路用到大模型。
到二十世纪初,这条线长成了”英国突现论”。塞缪尔·亚历山大(Samuel Alexander)1920年的《空间、时间与神》、劳埃德·摩根(C. Lloyd Morgan)1923年的《突现进化论》,主张生命、心智这些高层性质是从低层真正长出来的,没法从低层预测,但也不靠灵魂或生命力这种神秘东西。这是一种自然主义的立场,今天讨论涌现的人基本还站在这条线上。
1.2 一次塌房,一次翻身
涌现这个概念命运起伏很大。它第一次跌跟头,是因为量子力学。1927年海特勒(Heitler)和伦敦(London)用量子力学算出了氢分子的共价键,化学键这个曾经被当成”涌现”招牌例子的东西,原来可以从更底层的物理推出来。哲学家布莱恩·麦克劳林(Brian McLaughlin)1992年那篇《英国突现论的兴衰》就论证说,突现论的衰落正是因为它最好的实证例子被量子力学一个个收编了。
要补一句的是,”涌现只是无知的遮羞布”这个说法,更像是对麦克劳林论点的概括,而不是他的原话。而且近年也有学者质疑,量子力学到底有没有那么干净利落地干掉突现论,这件事本身还有争论。所以这里说的是麦克劳克林的论证,不是定论。
让涌现翻身的是物理学家菲利普·安德森(Philip Anderson)。1972年他在《科学》杂志上发了一篇四页的短文《More is Different》(多了就不一样,Science第177卷393到396页)。他的核心论点很硬:就算你承认万物都能还原到基本粒子和基本方程,你也没法反过来从基本方程重建出上层世界,因为每上一个复杂度层级,都会冒出全新的、低层语言描述不了的规律。
安德森举的机制叫对称性破缺,听着玄,例子很日常。一块铁,在高温下每个原子的小磁矩朝向乱七八糟,整体不显磁性,这时候它对各个方向是平等的。温度降到居里点以下,所有小磁矩会忽然集体选定同一个方向,铁就有了磁性。底层那条物理定律对所有方向一视同仁,可系统自己挑了一个方向站定,这个”挑”出来的宏观秩序,单看一个原子是看不出来的。这就是涌现,而且是写得出方程、算得出临界温度的那种。
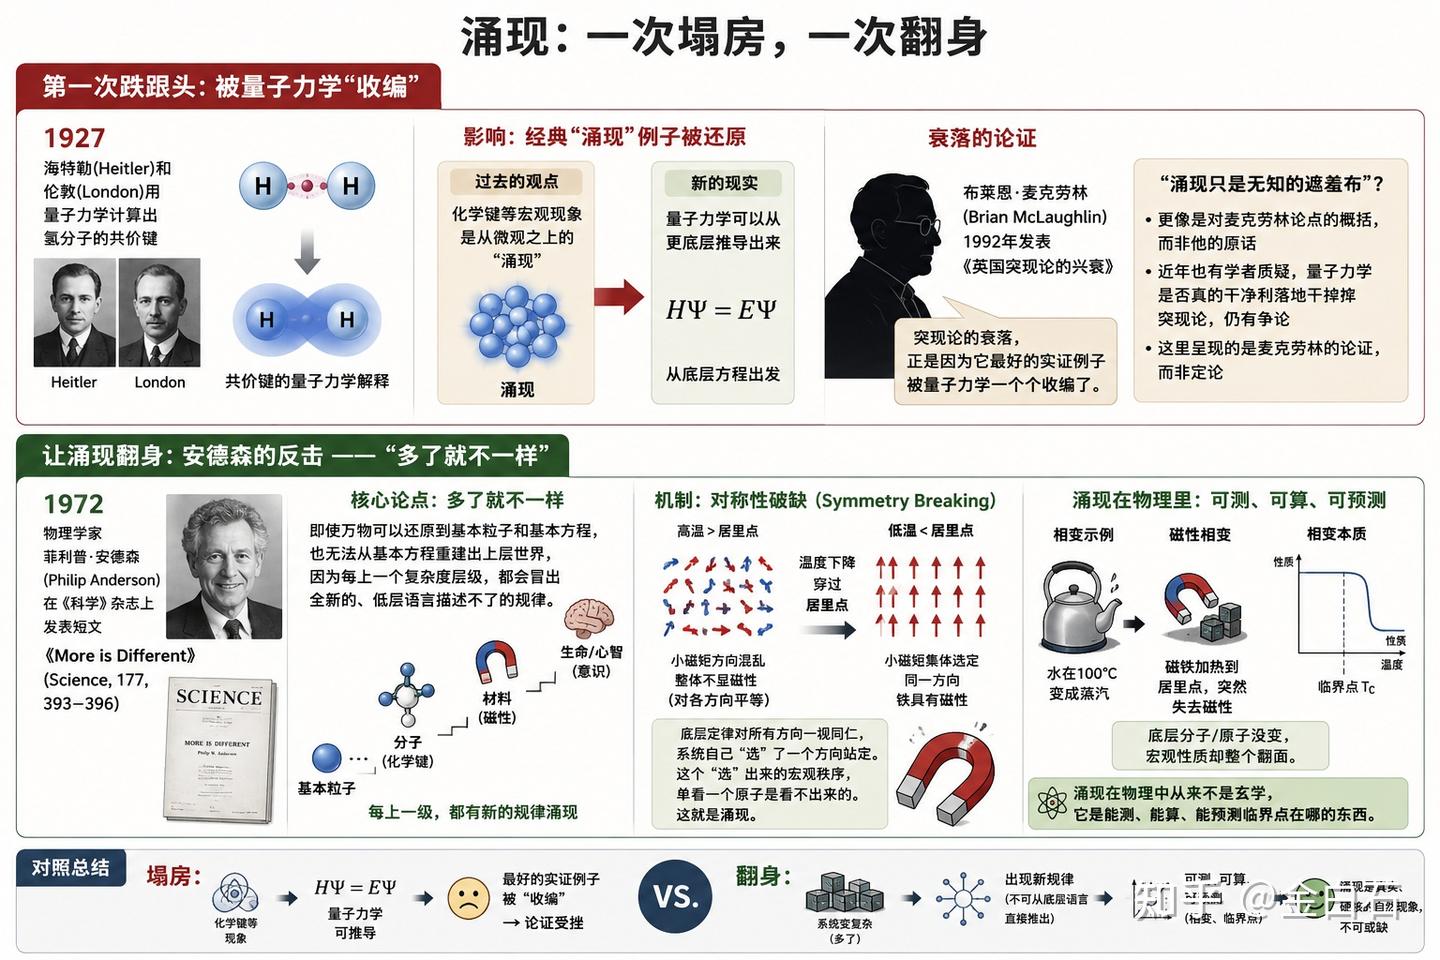
物理学家相信涌现,靠的是实验台上天天见的东西,不是哲学思辨。水烧到100摄氏度变成蒸汽,磁铁加热到居里点突然失去磁性,这些都是相变,都是底层分子没换、宏观性质却整个翻面的真实例子。涌现在物理里从来不是玄学,它是能测、能算、能预测临界点在哪的东西。这一点记住,后面对照AI时是关键。
1.3 一把贯穿全文的尺子:弱涌现与强涌现
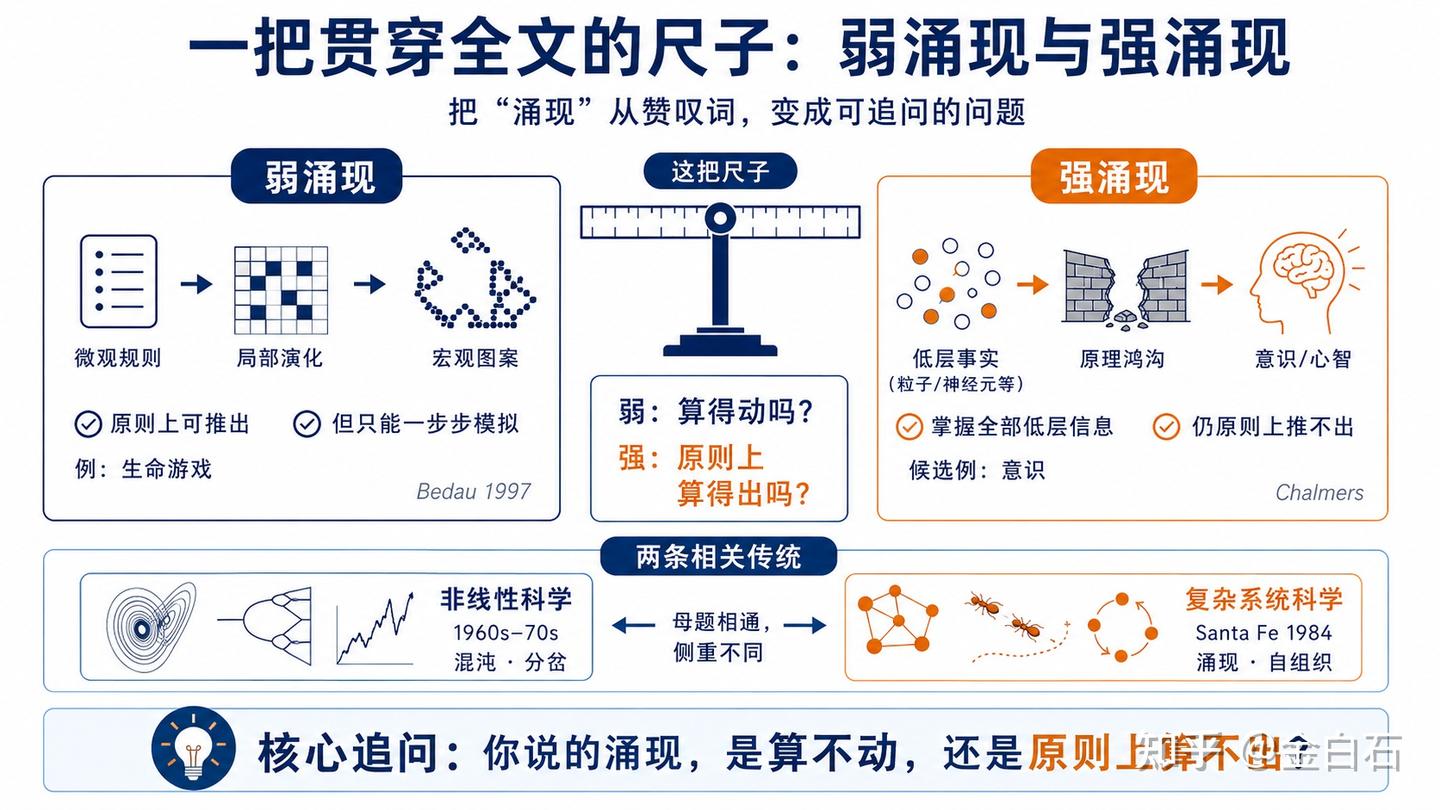
讨论到这里,需要一把统一的尺子,不然”涌现”两个字太滑。哲学家马克·贝多(Mark Bedau)1997年提出了”弱涌现”:宏观现象原则上能从微观规则推出来,但只能靠一步步模拟跑出来,没有捷径可走。生命游戏就是典型,规则简单到一行能写完,可你想知道某个初始格局几百步后长成什么样,只能老老实实让它跑。
另一头是”强涌现”,由戴维·查尔默斯(David Chalmers)说得最清楚:高层事实原则上就推不出来,哪怕你掌握了全部低层信息也不行。他举的候选例子是意识。强涌现到底存不存在,哲学界吵到今天没结论。
这把尺子的好处是,它把”涌现”从一个含糊的赞叹词,变成了一个可以追问的问题:你说的这个涌现,是算不动(弱),还是原则上算不出(强)?后面看AI的每一种涌现,我都会拿这把尺子量一量。
顺带说一句两条学术传统的分叉,后面对照时有用。研究”量变到质变”的科学其实分两脉:一脉是非线性科学,1960到70年代起来,核心是混沌和分岔。另一脉是复杂系统科学,1984年圣塔菲研究所成立后成形,约翰·霍兰德(John Holland)、斯图尔特·考夫曼(Stuart Kauffman)这些人,核心才是涌现和自组织。两脉共用”简单生复杂”的母题,但侧重不同。要说明的是,这两条线历史上是缠在一起的,圣塔菲自己的定位也包含非线性现象,别把它们想成泾渭分明的两个门派。
二、涌现在AI里其实有好几副面孔
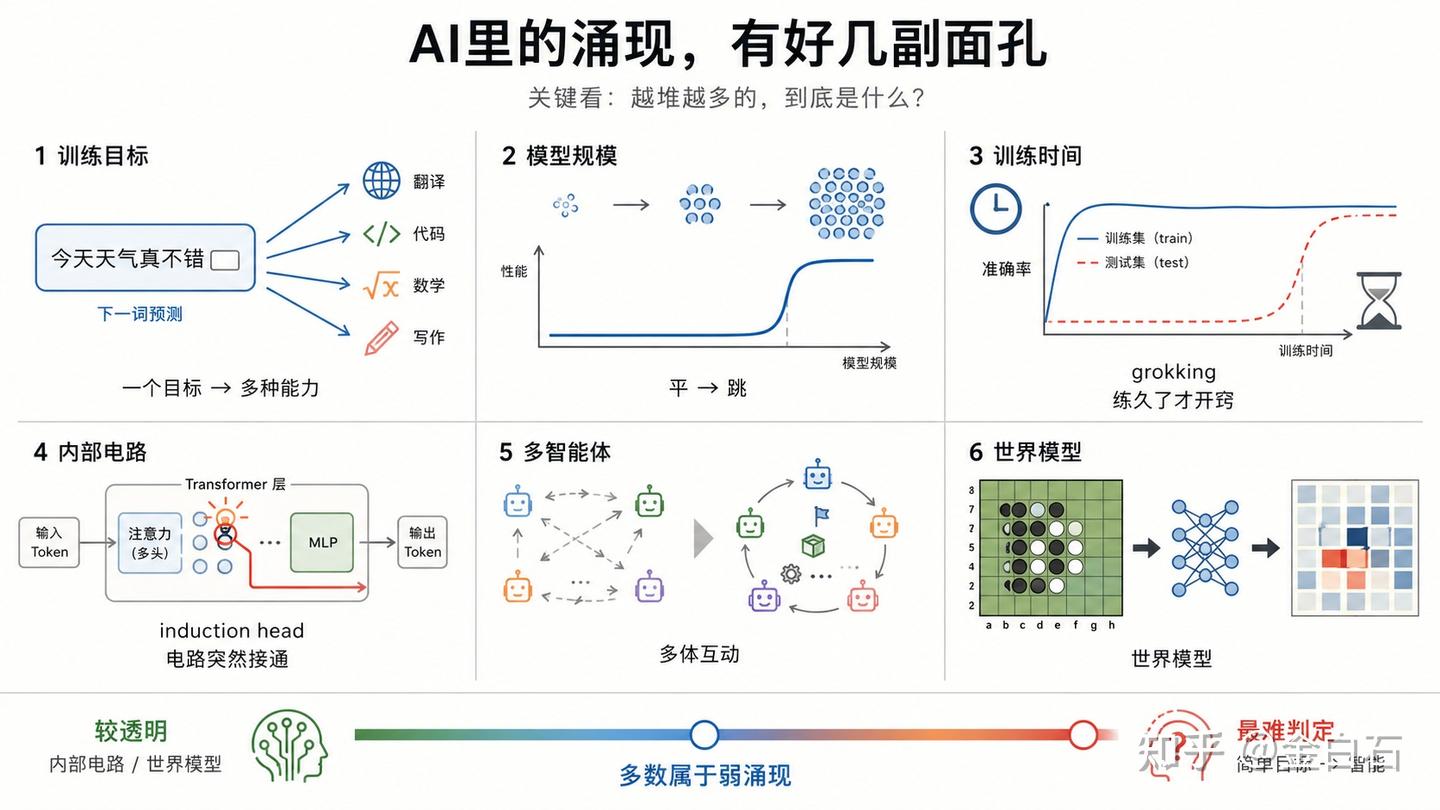
把“涌现”这个老概念搬进AI,第一件要破的事是:大家嘴里的”AI涌现”根本不是同一回事。判断是哪一种,关键看”越堆越多的到底是什么”。堆的东西不一样,涌现的内容就完全不同。
2.1 堆训练目标:只教一件事,长出一堆本事
最根本、也最像哲学命题的一种涌现是这样的:我们训练大语言模型,给的目标简单到近乎简陋:预测下一个词。就这一个目标,没教它翻译,没教它写代码,没教它做数学题。
可模型练完,这些本事它都有了。这就是2020年GPT-3那篇《Language Models are Few-Shot Learners》(Brown等,arXiv 2005.14165)让所有人吃惊的地方:一个1750亿参数的模型,只靠”猜下一个词”练出来,却能根据提示里给的几个例子直接上手做新任务,权重一动不动。这种”给几个示例就会”的能力,后来被叫做上下文学习(in-context learning)。
这件事值得停下来想一想有多怪。我们没有在模型里写进任何一条语法规则、任何一道数学公式、任何一段编程语法。整个训练过程就是反复做一件事:盖住下一个词,让模型猜,猜错了就微调权重。为了把这个游戏玩到极致,模型被逼着在内部建起了一整套关于语言、世界、逻辑的隐式结构,因为只有真”懂”了,才能把下一个词猜得更准。
这副面孔最接近涌现的原始哲学含义:整体的本事远超出训练目标这个”部分”。但它也最难量化,因为”智能”本身就难定义。它更像一个值得追问的现象,而不是一条能写进方程的结论。第一章那把弱涌现、强涌现的尺子在这里第一次派上用场,这种”简单目标长出智能”到底算难算(弱)还是算不可能(强),后面2.6节会回来量。
2.2 堆模型规模:涌现能力,后面争议的主角
这一节要讲的涌现最有名,也是后面整场争论的主角。它专指一件事:随着模型规模变大,某种能力会突然冒出来。2022年Jason Wei等人在TMLR上发了《Emergent Abilities of Large Language Models》(arXiv 2206.07682),给这个现象起了正式的名字,叫”涌现能力”。
先说清楚这里”堆”的是什么。堆的是模型规模,也就是参数量、训练数据和算力一起往上加。论文给”涌现能力”下的定义很干脆:一种能力,小模型身上没有,大模型身上才有。更要紧的一条是,这种能力没法从小模型的表现外推出来。你把一系列大小不同的模型排开,画一条规模对性能的曲线,小模型那一段一直平贴着随机乱猜的水平,看不出任何长进,可参数一旦堆过某个量级,性能会猛地往上一跳。论文里举了一串这样的任务:多步算术、大学水平的考试题(比如MMLU这个跨学科知识测试)、判断一个词在具体上下文里的真正含义。
拿多位数加法当例子最直观。模型小的时候基本是瞎蒙,准确率贴着零趴在地上。规模一档档往上加,加到某一档,准确率忽然从接近零窜到很高,中间几乎没有一个慢慢变好的斜坡。论文里好几个任务都是这个形状:平、平、平,然后到某个参数量上猛地起跳。
这件事为什么既让人激动又让人不安。激动,是因为它意味着光”把模型做大”本身,就能解锁原本没人专门教、也没人预料到的新能力,这正是Scaling这条路最诱人的承诺。不安,是因为这种冒头事先没法预测:你不知道下一个能力会在多大规模上出现,也不知道冒出来的会是什么本事。这一条直接关系到AI安全,后面会专门回来谈。这里先把那条曲线的形状记牢:平,平,平,然后突然一跳。
2.3 堆训练时间:grokking,练着练着突然开窍
上一节堆的是模型规模,这一节换个变量,堆的是训练时间。2022年OpenAI的Alethea Power等人发现一个怪现象,写进了《Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets》(arXiv 2201.02177)。
他们拿小型算法任务训练网络,比如模算术(钟表上的加法,超过12就绕回来)。网络很快就把训练集背得滚瓜烂熟,训练误差归零,但测试集上一塌糊涂,纯属死记硬背。按常理这时该停了,再练就是过拟合。可他们偏不停,继续练,练了很久很久之后,测试性能突然从随机水平蹿到接近满分,模型像是”开窍”了,真正学会了背后的规律。grokking这个词就是”顿悟”的意思。
这个现象怪在哪?常识里,一个模型一旦把训练集背熟、测试集还是不会,就该停了,再练只会越来越死记硬背。grokking偏偏反过来,在”看起来已经学废了”之后很久,泛化能力姗姗来迟。它说明模型在训练损失早就归零的那段平台期里,内部其实没闲着,一直在悄悄重组,只是这种重组在测试性能上要等很久才显形。这个”内部一直在动、外部很晚才看出来”的特点,是第三章那场争论的关键伏笔。
要提醒一句,grokking和上一节的涌现能力是两个东西,别混。涌现能力是随模型规模跳变,grokking是随训练时间跳变。一个堆参数,一个堆步数。它们长得像,机理不同,这是常见的混淆点。grokking后面在第三章还要重点出场,因为它是判断”涌现到底真不真”的一个关键样本。
2.4 训练中途,内部电路自己长出来
前面几种涌现,看的都是模型在外面表现出来的本事。这一种要钻进模型内部去看,靠的是机制可解释性,也就是把训练好的模型拆开,盯着它内部到底怎么算。2022年Anthropic的Catherine Olsson等人就这么干,他们在《In-context Learning and Induction Heads》(arXiv 2209.11895)里,全程盯着一个模型训练过程里内部结构的变化。
先说清楚他们在找什么。前面提过”上下文学习”:你在提示里给模型几个例子,它不重新训练就能照着做新任务。这套本事背后,到底是模型里的什么东西在撑着?他们找到了一个具体的小零件,叫”归纳头”(induction head)。
归纳头干的事,说穿了就是”照抄上一回”。它会在前文里翻一翻:当前这个词,上次出现的时候,后面紧跟的是什么?然后把那个词抄过来当预测。举个例子,一段话里”阿尔法”第一次出现时后面跟着”小队”,等模型再读到”阿尔法”,归纳头就记起上回后面是”小队”,于是预测下一个词还是”小队”。就这么个”找到上次、复制下一个”的小把戏,被认为是上下文学习能力最主要的来源之一。
真正戳中本文主题的,是这个小零件冒出来的方式。它的出现很突兀,在训练进行到某个时刻才忽然接通,之前几乎没有铺垫。接通的那一瞬间,训练误差曲线上会鼓出一个肉眼可见的小台阶,与此同时,模型”照着例子学”的本事跟着跳一档。这就是一次实打实的”训练中的相变”:一个新本领像开关那样,在某一刻啪地接上。最难得的是,因为这件事发生在模型内部,研究者能把这块电路直接揪出来摆到台面上看,这是少有的、能被拆开验明正身的涌现。
要补一句分寸。Olsson他们自己也说,这套说法目前还是个有初步、间接证据的假说,在小模型上最有把握,别当成在所有大模型上都已坐实的定论。
2.5 堆数量、堆数据:多智能体与世界模型
还有几种涌现,简单提一下就行。它们离复杂系统的本义最近,也正好给第四章那场新老对照埋个伏笔。
一种是堆智能体数量。让很多个AI智能体凑在一起互动,整体会冒出单个智能体身上没有的协调、分工、博弈行为。这跟蚁群、鸟群那套经典涌现几乎是一个模子,是AI里离复杂系统原义最近的一种。
另一种是堆训练数据,模型内部会自发长出”世界模型”。2022年Kenneth Li等人做了个漂亮实验《Emergent World Representations》(arXiv 2210.13382):他们只用黑白棋(Othello)的落子序列训练一个GPT,从不告诉它规则,结果发现模型内部居然有一份棋盘状态的表示,用探针能读出来,改动这份表示还能因果地改变模型预测的合法落子。要补一个常被搞错的细节:Li他们原文是用非线性探针读出来的,后来Neel Nanda指出,只要把每个格子表示成”我方还是对方”而不是绝对的黑白,这份世界模型其实是线性的(arXiv 2309.00941)。
2.6 拿尺子排个序
把上面这几种涌现,都拿1.3那把”弱涌现、强涌现”的尺子量一量、排个序,画面就清楚了。
多智能体涌现离复杂系统本义最近,但说穿了是弱涌现,规则都在你手里,只是互动一多算不动。世界模型、上下文学习、归纳头、grokking也都落在弱涌现这一档:原则上都能从权重和数据推出来,难在算不动、看不透,谈不上什么原则上的不可能。归纳头这种甚至已经被人把电路拆出来看明白了,是弱涌现里最”透明”的一例。
真正悬而未决的是2.1那种”简单目标长出智能”。如果哪天证明大模型的某种理解是怎么也没法从底层推出来的,那才碰到强涌现的边。目前没人能下这个结论。换句话说,AI里热闹的这些涌现,绝大多数是”难”,不是”不可能”。这个判断很重要,它意味着这些现象原则上是可以被拆开看的,而这正是第三章那场争论能打起来的前提。
三、那场关于”涌现到底真不真”的争论
前面说涌现能力的曲线长这样:平,平,一直平缓,然后突然一跳。这一跳到底是真的,还是画出来的?这就是整篇文章张力最大的地方。
3.1 质疑:所谓涌现,可能是海市蜃楼
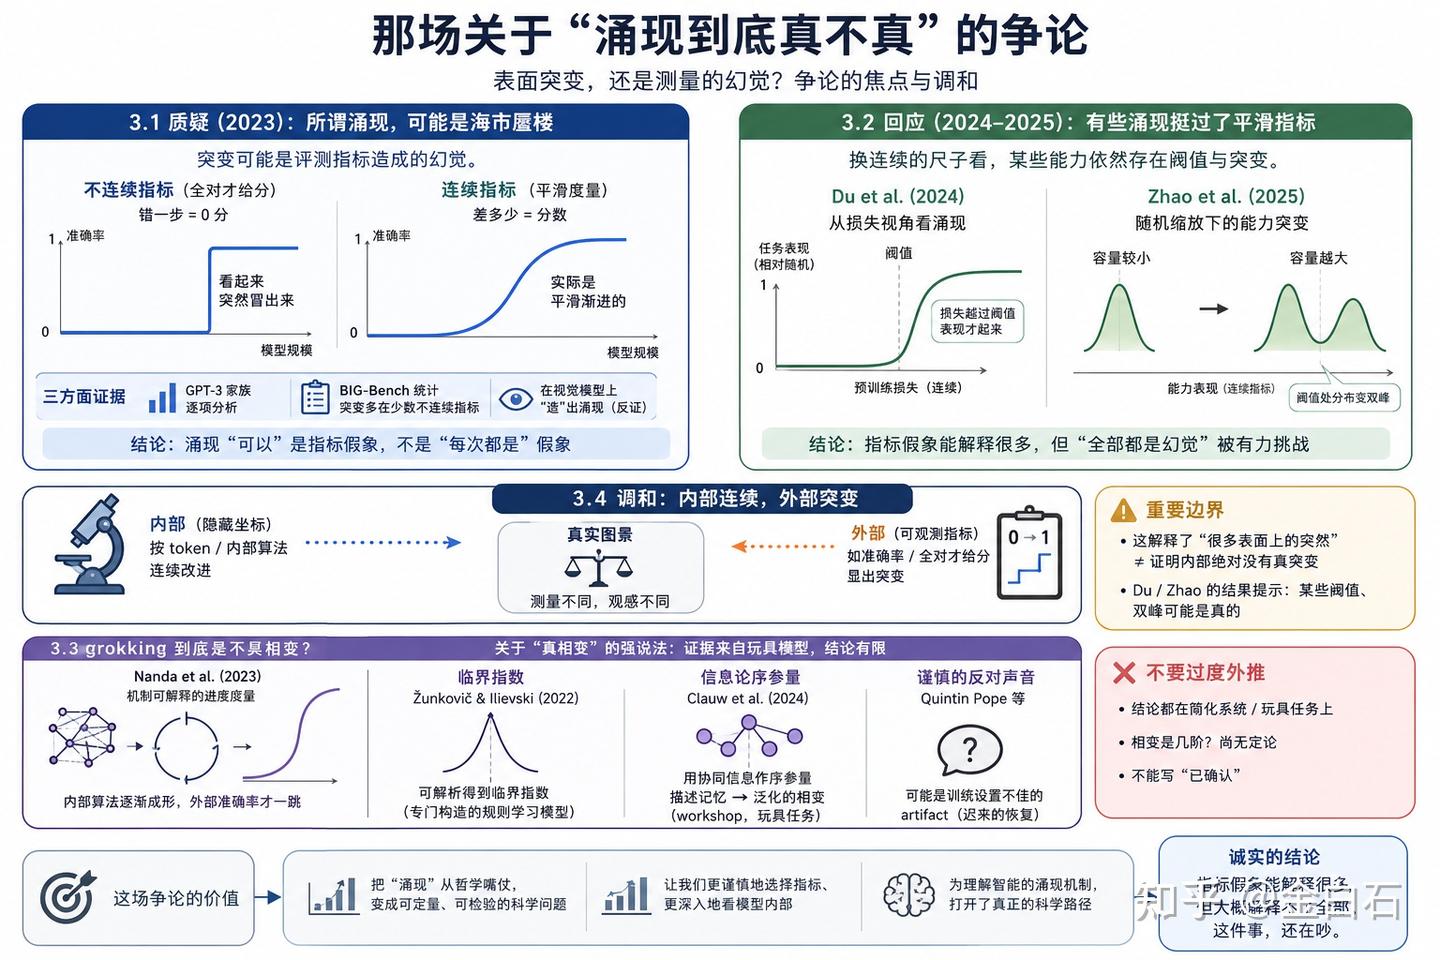
2023年,斯坦福的Rylan Schaeffer、Brando Miranda、Sanmi Koyejo三人发了一篇《Are Emergent Abilities of Large Language Models a Mirage?》(arXiv 2304.15004),直译就是”大模型的涌现能力是海市蜃楼吗”。这篇拿了NeurIPS 2023的杰出论文奖,分量很重。
他们的论证要说准确,不然容易误读。他们没有说大模型的能力不增长。他们说的是,那种”突然冒出来”的观感,很大程度是研究者选的评测指标造成的。
关键在指标连不连续。很多任务用的是”全对才算分”这类指标,比如多步算术,错一步整道题零分。模型从”错一步”进步到”全对”,在这种指标上看就是从0跳到1,像突变。可要是换一个平滑的指标,比如看模型输出和正确答案差几个字符,或者看它给正确token的概率,同一批模型输出画出来的曲线就是平滑、渐进、可预测的。同一个模型,同一批输出,换把尺子量,突变就化没了。
打个比方,一道要分五步才能做完的大题,老师只看最后答案,对了给满分,错了给零分。一个学生从”五步里做对四步”进步到”五步全做对”,真实水平是一步一步爬上来的,可在这种”错一步就零分”的判法下,他的成绩单是从零分一夜跳到满分。前四步做对其实已经很接近了,但只要最后没全对,分数就还是零,所以那一跳全是判分方式造出来的。突变在成绩单上,不在学生身上。他们拿三方面证据支撑这个论点:GPT-3家族的逐项分析、对BIG-Bench几百个任务的统计(涌现绝大多数集中在少数几种不连续指标上)、还有故意在视觉模型上”造”出一个涌现来反证。
要替这篇论文划个边界:他们证明的是涌现”可以”被解释成指标假象,不是”一定”在每个case里都是假象。这个分寸后面有用。
3.2 回应:有些涌现挺过了平滑指标
海市蜃楼这个论证太漂亮,一度让人觉得涌现的故事就此收场。但争论没这么快结束,另一方很快拿出了证据。
2024年Du等人发了《Understanding Emergent Abilities from the Loss Perspective》(arXiv 2403.15796,NeurIPS 2024)。他们换了个横轴,不看模型规模,改看预训练损失,这是个连续量,不是那种会造假象的离散指标。结果发现,有些任务在损失降到某个阈值之前一直贴着随机水平,越过阈值才起来。也就是说,换了连续的尺子,涌现照样在。
2025年Zhao等人的《Random Scaling of Emergent Capabilities》(arXiv 2502.17356)又补了一刀,论证说有些能力的突变来自不同随机种子之间结果分布的变化,在某个容量阈值上分布变成双峰,而且这个现象在连续损失指标下依然存在。
所以平心而论,指标选择确实解释了报道出来的很多涌现,这是Schaeffer的功劳。但”所有涌现都是幻觉”这个强版本,已经被有力地挑战了。诚实的说法是:指标假象能解释很多,但大概解释不了全部,这件事还在吵。
3.3 grokking到底是不是真相变
争论到这里,自然会问一句:有没有哪种AI涌现,是经得起最严格检验的”真”涌现?很多人把希望押在grokking上,因为它在小任务上能被反复复现,最适合解剖。这一节我要格外小心,因为这里是最容易被科普文章吹过头的地方。
最扎实的一块来自2023年Neel Nanda等人的《Progress measures for grokking via mechanistic interpretability》(arXiv 2301.05217)。他们把一个单层transformer做模加法的过程彻底逆向工程,发现网络其实学会了一套用三角函数、把加法变成圆周上旋转的算法。更关键的是,他们构造了”进度度量”,能看出模型内部的进步其实是连续、渐进的,哪怕测试准确率在外面看起来是突然一跳。这是这个领域最可靠的一个发现。要注意,这是个玩具模型,不是大语言模型。
那”grokking是一场带临界指数、带序参量的真相变”这种说法呢?这是个overclaim,得拆开说。临界指数那部分,其实来自Žunkovič和Ilievski的《Grokking phase transitions in learning local rules》(arXiv 2210.15435),他们能解析地算出临界指数,但那是在一个专门构造的、可解的规则学习模型里,不是一般神经网络。信息论序参量那部分,来自Clauw等人2024年的一篇工作(arXiv 2408.08944),用高阶互信息里的协同信息当序参量,把grokking描述成从”记忆”到”泛化”的相变。这篇还停在workshop阶段,也是玩具任务。
把这三篇拼在一起说成”grokking已被确认为真相变”,是把三个各自范围很窄的玩具模型结果,包装成了一个板上钉钉的共识。事实上连这个相变是几阶的都还没定论,也有研究者(比如Quintin Pope)干脆认为grokking主要是训练设置太糟糕造成的artifact,叫它”过拟合之后的迟来恢复”更准确。所以诚实的措辞是:好几条线索把grokking往相变上靠,在模加法这类玩具任务上甚至能解析地算出临界指数、提出信息论序参量,但都在简化系统上,相变的阶数还在争,也有人根本不认。不能写”已确认”。
3.4 调和:内部连续,外部突变
吵到最后,可能会发现”渐变还是突变”本身就是个伪问题。把两边的发现摆在一起,会浮出一个相当稳的共识。
Schaeffer说的是,底层那个按token算的量在平滑改进,突变出在测量这一环。Nanda说的是,模型内部那套算法在逐渐成形(进度度量看得见),突变出在你盯着看的那个可观测量(测试准确率)。两条路指向同一个结论:你盯着看的东西突然一跳,不代表模型内部真的有什么东西突然一跳。
这是整片争议里最少争议、也最值得记住的一句话:在隐藏的内部坐标上是连续推进,在我们能观测的指标上才显出突变。
但别把这句话推过头。这个调和说的是”很多表面上的突然,换一把内部的尺子去量就化掉了”,它没有证明内部绝对没有任何真突变,Du和Zhao那两篇恰恰提示某些阈值和双峰可能是真的。所以它是一个强有力的默认框架,还算不上最终结论。
这场争论真正的价值,不在于谁赢。在于它把”涌现”从一个哲学嘴仗,变成了一个能定量、能拿数据反复拷问的对象。这一点,是AI给这个老概念带来的最大改变,也是下一章的引子。
四、老涌现和AI涌现,到底是不是一回事
绕了一大圈,回到最初的问题。物理里那个能写方程的涌现,和AI里这个吵翻天的涌现,是同一个东西,还是只是借了同一个名字?我的看法是,同根,但变异了。先把结论摆成一张表,下面几节再逐条展开。
| 维度 | 老涌现(物理/复杂系统) | AI涌现(大模型) |
|---|---|---|
| 共同母题 | 量变到质变,整体不等于部分之和 | 同 |
| 数学工具 | 相变理论、序参量、临界指数 | 借用同一套语言和直觉 |
| 能否写出底层方程 | 能(如磁性的朗道理论) | 暂时不能,靠经验拟合 |
| 实验成本 | 高,有时根本无法重做 | 极低,可反复重跑 |
| 能否拆开内部看 | 多数不能 | 能,可解释性可拆电路 |
| “突然”能否被证伪 | 写在方程里,谈不上证伪 | 第一次成了可证伪的命题 |
4.1 相同:共享母题,也共享数学直觉
先说相同的部分,这部分很实在。它们共享同一个母题,量变到质变,整体不等于部分之和,这条从密尔到大模型一脉相承。它们也共享”简单生复杂”的家族相似,生命游戏的简单规则长出复杂图案,和简单的”预测下一个词”长出语言能力,气质上是一类。
更具体的是,连数学直觉都是借来的。AI研究者描述涌现能力时用的”突变”“阈值”“临界”,这套词汇和图像直接来自物理的相变理论。第三章里grokking研究者画相图、找序参量、算临界指数,用的就是统计物理那一整套工具。从这个角度看,AI涌现是物理涌现的概念后裔,这一点没有疑问。
4.2 不同之一:能不能写出方程
最硬的区别在这里。物理里的涌现,是能写出方程的。水的相变有范德瓦尔斯方程,磁性的相变有朗道理论,你能从一个明确的自由能函数推出临界点在哪、临界指数是多少,而且实验测出来的数值和理论算出来的对得上。物理涌现的”突然”,是写在方程里的,是可推导的。
AI涌现到现在写不出这样的底层方程。我们手里最像方程的是Scaling Law,一条经验拟合的曲线,能告诉你随着参数、数据、算力往上加,训练损失大致怎么往下掉。但它有两个硬伤。一是它从数据里拟合出来,不是从第一性原理推出来的,物理的朗道理论是先有理论再被实验验证,Scaling Law是先有数据再去拟合一条线。二是它管的是平滑下降的总损失,恰恰预测不了某个具体能力会在哪个点突然冒出来,而后者才是”涌现”最让人头疼的部分。
所以AI涌现目前是个半经验现象,靠观测,不靠推导。第三章grokking那些”相变”结论之所以珍贵又脆弱,正因为它们只在能写出方程的玩具模型里成立,一到真实大模型就又回到了”算不出”的状态。能写方程的地方涌现是小玩具,真正想懂的大模型又写不出方程,这个落差是这门学问现在最难受的地方。
4.3 不同之二:可实验性这个新维度
这是AI给老涌现带来的真正新东西,也是我觉得最有意思的一点。
物理里的涌现,实验其实很贵很难。你想研究水的临界点,得真把水加压加热逼到那个点附近,设备、时间、成本都是硬约束。你想研究早期宇宙的相变,根本没法重做,只能靠理论加间接观测。我做天体物理时对这种无力感很有体会,很多”涌现”你只能远远看着,没法伸手去拨弄。
AI涌现不一样,它便宜得离谱。想知道某个能力在哪个规模冒出来,把模型从小到大跑一串就行。想知道是不是指标造成的假象,换个指标重算一遍同一批输出,几小时的事。想知道grokking内部到底发生了什么,可以用可解释性工具把那一层网络的电路直接拆开看,看它学的是不是三角函数算法。这种”反复重跑、随意改一个变量、还能把内部掰开”的能力,是物理涌现做梦都想要的。涌现这个老概念,第一次被放进了一个能反复做实验的沙盒。
要说清楚的是,这不等于AI涌现就比物理涌现”高级”。它写不出方程,这是短板。但它能被反复实验拷问,这是物理给不了的长处。一短一长,是变异,不是升级。
4.4 收口:第一个被证伪的,恰是AI最有名的那个案例
把4.3那句”可以反复实验拷问”再往前推一步,就到了这篇文章最想讲的那个点。
可实验性带来的第一个直接后果,是”涌现的突然性”第一次成了一个能证伪的命题。在物理里你没法说相变的突然是”假象”,因为它写在方程里、测在仪器上。在AI里,第一次有人能站出来说:等等,这个突然可能是你的尺子造成的,我换把尺子给你看。这就是Schaeffer那篇海市蜃楼。
而被这把新尺子第一个量出问题的,恰恰是AI涌现里最出名、最被反复引用的那个案例,Wei 2022的涌现能力。提出”涌现能力”这个概念才一年,”它是不是幻觉”就被摆上了台面。这并不意味着Wei错了,第三章也讲了反方证明有些涌现挺过了平滑指标。这件事真正的意味在于,可证伪性的第一个战果,是动摇了这个领域自己最响亮的招牌。
一个概念成熟的标志,往往是它第一次能被自己的方法反咬一口。涌现搬进AI,最大的收获是它终于变成了一个可以被怀疑、被检验、被证伪的科学对象。比起又多几句”模型涌现出XX”的惊叹,这才是真的进展。
五、还没解决的问题
前面几章讲的,大多是已经有些眉目的部分。这一章换个方向,摆几个目前还没有答案、但我认为最要紧的开放问题,也算给这个还在生长的话题留个钩子。
5.1 能不能找到”涌现定律”,这直接关系AI安全
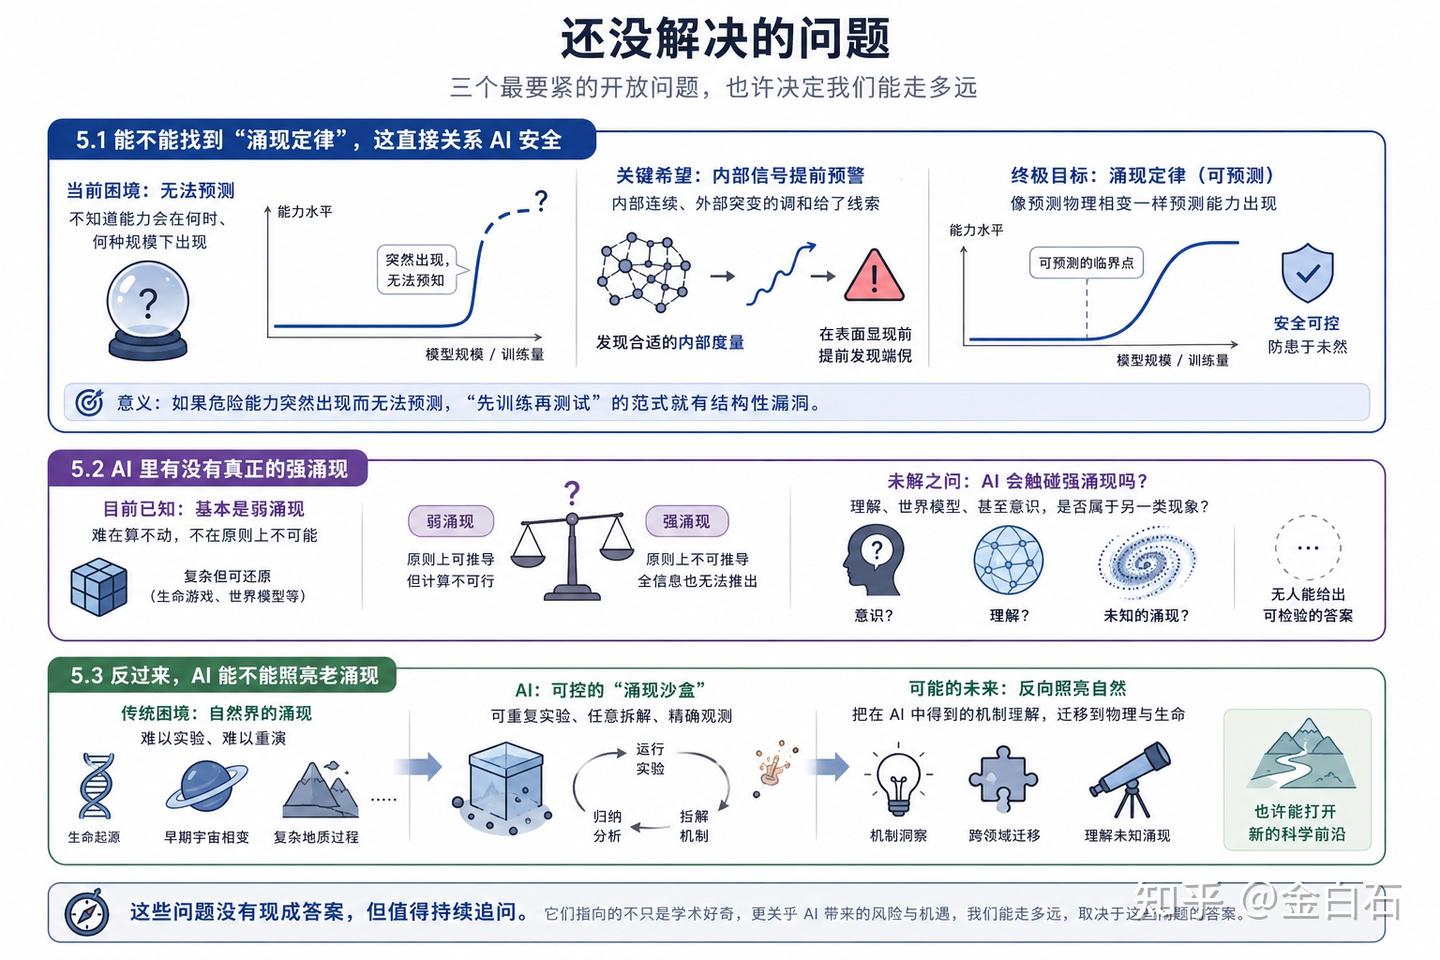
物理的相变能预测,你知道水在标准大气压下100摄氏度沸腾,能算出临界温度。AI涌现现在做不到,没人能在训练前就算准某个能力会在多大规模、多少数据下冒出来。
有没有可能找到一套”涌现定律”,让能力的出现变得可预测?这不只是学术好奇。它直接关系AI安全。如果一个模型的危险能力,比如帮人合成毒剂、自动找软件漏洞,会在某个没人预料到的规模上突然出现,而我们事先算不出来,那”先训练再测试”的安全范式就有结构性的漏洞,等你测出来,模型已经训出来了。
第三章那个”内部连续、外部突变”的调和给了一点希望:如果能找到合适的内部度量,也许能在能力还没在表面显形之前,就从内部信号里提前看出端倪。这正是可解释性研究最实用的价值之一。能不能把涌现变得可预测,可能是未来几年AI安全最实在的技术问题之一。这件事能不能做到、什么时候做到,目前都是开放的。
5.2 AI里有没有真正的强涌现
用1.3那把尺子,前面说AI里热闹的涌现基本都是弱涌现,难在算不动,不在原则上不可能。那有没有真正的强涌现?
理解、世界模型、乃至某种意义上的”意识”,是弱涌现推到极端,还是另有一类东西?黑白棋实验告诉我们模型内部能长出世界模型,可那还是个能被探针读出来、能被还原的弱涌现。强涌现那条线,AI碰到了没有,目前没人能给出可检验的回答。这大概是整个领域最深、也最容易滑进玄学的一个问题。
5.3 反过来,AI能不能照亮老涌现
最后一个方向我自己最期待,它把前面的逻辑整个反了过来。AI这个”能反复做实验的涌现沙盒”,能不能回头帮我们理解物理和生命里那些做不了实验的老涌现?
很多自然界的涌现,比如生命起源、早期宇宙的相变,没法在实验室重演。而AI里的涌现可以随意重跑、拆解。如果我们能在AI这个可控系统里把”涌现到底怎么发生”搞清楚,那套理解有没有可能借给物理和生物?这是不是一厢情愿,现在还看不准,但它至少是个具体、能动手试的方向。
结语
绕回开头那个问题:大模型的涌现,是真本事还是统计幻觉?
诚实的答案是两样都有。一部分被叫做涌现的突变,换把尺子量就化掉了,那是测量的产物。另一部分挺过了最严格的检验,那是真的。比这个比例停在哪更重要的是,我们头一回有了办法去测它。
往大里说,这两百年涌现一直是那种能写出方程、却很难搬上实验台的概念,从密尔的化学例子到安德森的相变都是如此。进了AI,它把这两样对调了:底层方程暂时写不出来,可实验随时能做,科学地位从”算得出”挪到了”试得了”。
我做物理那些年,涌现是个让人敬畏的词,因为它指向那些你算得出、却拨弄不动的东西。到了AI,同一个词让人手痒,因为你终于能伸手进去拨一拨,看它到底怎么动。也许涌现取决于我们选在哪一层去看世界,而不是世界本身的某种客观属性。这个猜想老到密尔那代人就隐约想过,新鲜的只是,这一回我们终于能动手去验它。